
Сравнение результатов классификаторов
Как уже было описано ранее, в настоящей работе разрешение анафорических связей рассматривается как задача классификации. Для реализации алгоритмов классификации была выбрала библиотека scikit-learn URL: http: //scikit-learn.org/stable/index.html на языке программирования Python. В данной библиотеке представлено большое количество алгоритмов классификации, среди которых были выбраны самые популярные: Логистическая регрессия, Наивный байесовский классификатор, Метод k ближайших соседей, Дерево решений и Метод опорных векторов (SVM). Для начала было решено проверить, какой алгоритм классификации покажет лучший результат на базовых признаках. И в последствии использовать лучший классификатор для изучения влияния синтаксических признаков. Кроме этого, при выделении именных групп - кандидатов, в работе было решено взять дистанцию в три предложения перед предложением с местоимением. Данный промежуток превосходит в длине те промежутки, которые были взяты за основу в алгоритмах для русского языка, описанных в разделе анализа существующих систем. Поэтому было решено проверить, как влияет промежуток на работу классификаторов, а именно, был взят промежуток D1 равный трем предложениям перед исходным, и промежуток D2 равный двум предложениям перед исходным.
После обработки текстов, были получены данные показанные в таблице 2.
Таблица 2.
|
Дистанция |
D1 |
D2 |
|
Положительные вектора |
2 367 |
2 072 |
|
Отрицательные вектора |
35 028 |
27 092 |
|
Всего |
37 395 |
29 164 |
Под положительными векторами понимаются вектора, относящиеся к парам антецедент + анафор, которые оказались анафорическими. Число положительных векторов растет при увеличении дистанции потому, что на одной дистанции могут оказаться несколько антецедентов сразу. Распределение на положительные и отрицательные получилось неравномерным, поэтому была взята только часть отрицательных векторов в соотношение 2 к 1 в пользу отрицательных. Тренировочный набор векторов состоит из 70 процентов от всего набора положительных векторов, соответственно тестовый набор - 30 процентов. При проверке дистанции было решено использовать минимальное количество из положительных векторов, т.е. 2072. Таким образом, число отрицательных векторов было равно 4000.
Результаты работы классификаторов представлены в таблице 3.
Таблица 3.
|
Precision |
Recall |
F1-score |
||
|
Логистическая регрессия |
D1 |
0.74 |
0.39 |
0.51 |
|
D2 |
0.74 |
0.38 |
0.50 |
|
|
Наивный Байес |
D1 |
0.56 |
0.61 |
0.58 |
|
D2 |
0.58 |
0.62 |
0.60 |
|
|
K ближайших соседей |
D1 |
0.71 |
0.53 |
0.61 |
|
D2 |
0.68 |
0.54 |
0.60 |
|
|
Дерево решений |
D1 |
0.61 |
0.52 |
0.57 |
|
D2 |
0.62 |
0.56 |
0.59 |
|
|
Метод опорных векторов |
D1 |
0.76 |
0.53 |
0.63 |
|
D2 |
0.82 |
0.39 |
0.52 |
В схеме 2 наглядно показаны результаты работы классификаторов.
Схема 2.
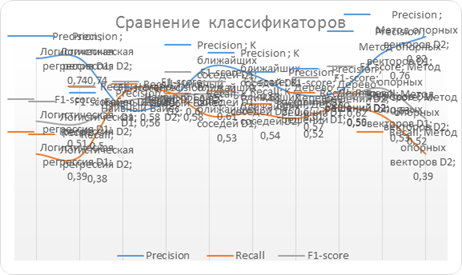
Схема 2 показывает, как влияет дистанция на каждый классификатор. Классификатор "Логистическая регрессия" показывает примерно одинаковые результаты на данных разной длины. "Наивный Байес" чуть лучше справился с задачей классификации, чем предыдущий алгоритм, но в любом случае, изменение данных практически не повлияло на работу классификатора. Метод "k ближайших соседей показал лучший результат на большей дистанции (D1), однако разница в 0.01 не является значимой. Алгоритм "дерево решений" аналогично практически не зависим от дистанции. И наконец "Метод опорных компонент" показал намного более худшие результаты на дистанции в два предложения (разница 0.11).
Анализ данной схемы дает следующие результаты: для всех классификаторов, кроме "метода опорных векторов", увеличение дистанции в среднем практически не влияет на работу классификатора (в среднем означает F1-score, потому как он отражает среднее между Precision и Recall); изменение дистанции в большей степени повлияла на SVM. Если сравнивать классификаторы между собой, то в среднем, они дают приблизительно одинаковые результаты, кроме классификатора "метод опорных векторов". Последний алгоритм показал лучшие результаты на дистанции D1. На основе данной статистики было решено использовать SVM в качестве основного метода классификации, при этом оставив дистанцию D1, то есть три предложения перед исходным с анафором.