
Тета-метод, ARIMA
Тета-метод
Метод основан на концепции преобразования временного ряда с помощью некоторого коэффициента «Тета» (греческая буква ). Полученные ряды поддерживают среднее значение и тенеденцию исходных данных, а не их отклонения. Такие ряды называются Тета-рядами, или Тета-линиями. Их основной качественной характеристикой является усовершенствование адекватности долгосрочной тенденции данных или увеличение краткосрочных характеристик, в зависимости от значения коэффициента Тета. При применении данной модели исходный временной ряд представляется в виде двух и более Тета-рядов. Прогноз делается отдельно для каждого ряда, а итоговый прогноз - усредненное значение полученных значений (V. Assimakopoulos*, K. Nikolopoulos).
Комбинирование прогнозных значений с учетом определенных факторов увеличивает точность прогнозного значения (Clemen, 1989). Причиной тому является усреднение ошибочных значений для каждого использованного метода. В каждой модели присутствует определенная логика поведения значений, более или менее гибкая для разных способов, которая экстраполируется в будущее. Поэтому Тета-метод является альтернативным способом разложения и/или дополнения к концепции комбинирования.
Основа модели - концепция модификации локальных искривлений временного ряда. Эти искривления выражаются с помощью коэффициента Тета:
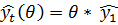
,
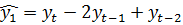
Где .
Если искривления ряда постепенно уменьшаются, то временной ряд постепенно снижается (рис.5)
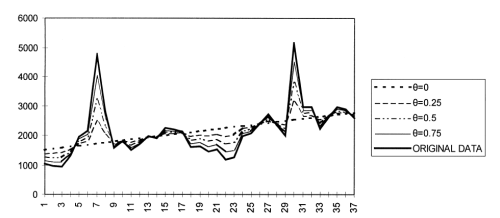
Рис.5 Разложение временного ряда.
Меньшее значение Тета-коэффициента соответствует большему уровню дефляции. В крайнем случае, когда =0, временной ряд превращается в линейный тренд. Постепенный спад колебаний снижает абсолютную величину разниц между последовательными периодами полученного ряда и относятся, в количественном отношении, к возникшему долгосрочному тренду данных (Assimakopoulos, 1995).
У -коэффициента также могут быть и отрицательные значения, однако они не представляют никакого интереса в данном случае, поэтому в дальнейшем не будут рассмотрены.
Если искривления возрастают (>1), то временной ряд расширяется, как показано на рисунке 6.
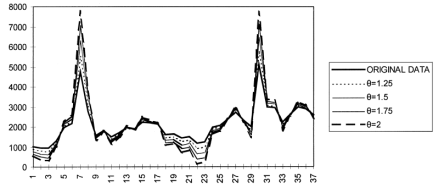
Рис.6 Тета-модель
Следуя вышеуказанному, строятся новые временные ряды, которые называются Тета-рядами. Положение полученных рядов относительно исходных данных может быть различным. При подгонке линейного тренда методом наименьших квадратов тренды для разных Тета-линий совпадают.
Общая формулировка изучаемого метода:
Исходный временной ряд декомпозируется на два или более Тета-ряда. Каждый из этих рядов экстраполируется обособленно, а прогнозы попросту комбинируются. Любой метод прогнозирования может быть использован для экстраполяции Тета-ряда, согласно предыдущему опыту (Fildes, Hibon, Makridakis & Meade, 1998). Различные комбинации Тета-рядов могут быть использованы для каждого горизонта прогнозирования.
Это хорошо демонстрируется при изучении простейшего случая, в котором оригинальный временной ряд раскладывается на два Тета-ряда, например при =0 и =2:
Y=1/2(L(=0)+L(=2)),
где L(=0) означает Тета Ряд для параметра, равного 0.
Первый Тета-ряд(=0) является линейной регрессией исходных данных, а конечные разности второго ряда ровно в два раза больше исследуемого временного ряда. Данный случай является примпером, когда составляются два экстремальных и симметричных 1 Тета-ряда. Первый компонент L(=0) описывает временной ряд с помощью линейного тренда. Второй - L(=2) удваивает значения искривлений в краткосрочной перспективе.
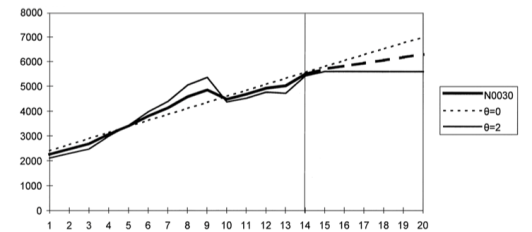
Рис. 7. Прогноз Тета-методом.
Первый Тета-ряд описывается с помощью простого линейного тренда, в то время как второй экстраполируется посредвом простого экспоненциального сглаживания. Среднее арифметическое полученных значений является окончательным результатом прогнозирования изучаемого временного ряда с помощью Тета-модели (рисунок 7).
Резюмируя, выделим основные этапы прогнозирования с помощью Тета-модели:
- (сезонная составляющая). Для начала изучаемый временной ряд анализируется на наличие сезонной составляющей. Критерием является t-тест для автокорреляционной функции (этот этап имеет место, когда имеются ежемесячные данные).
- (декомпозиция). Временной ряд раскладывается на два Тета-ряда: линейной регрессии при =0 и Тета-ряд при =2.
- (экстраполяция). Линейная регрессия экстраполируется простым путем, в то время как второй ряд - с помощью экспоненциального сглаживания.
- (комбинирование). Прогнозные значения составляются с помощью простого арифметического среднего полученных в пункте 3 значений.
Оценка метода.
Важной особенностью этого метода является декомпозиция исходных данных. Два компонента включают в себя информацию, которая полезна для прогнозирования, однако потеряна или не может быть полностью учитана существующими методами прогнозирования спроса. Тенденция особенно понятна при =0. Прямая линия включает в себя информацию для долгосрочного тренда некоторых временных рядов, которые пренебрегаются при попытке учесть более свежие тенденции. С другой стороны, когда используется только линейный тренд, игнорируется вся ценная информация о краткосрочных изменениях.
При прогнозировании спроса Тета-методом долгосрочный тренд включается посредством компонента L(=0) и экстраполяция является прямой. На ряду с этим, наличие L(=2) создает контрбаланс простоте использования простой модели линейного тренда. Компонент L(=2) увеличивает кривизну данных и увеличивает значение последних тенденций, чтобы средняя двух Тета-линий совпадала с исходным рядом. Так как экстраполяция L(=2) горизонтальная, прогноз сохраняет заниженное, но постоянное значение долгосрочного тренда.
ARIMA
В ходе исследования динамики туристских прибытий в Индию, К. Бхаттачарья обнаружил, что экспоненциальное сглаживание наиболее точно прогнозирует по трём критериям точности из пяти, немного уступая по оставшимся двум критериям моделям ARIMA (Bhattacharya, 2011). Конкурентами, помимо моделей ARIMA, выступают наивные методы, регрессия с переменными-индикаторами сезонности и авторегрессионные модели распределённых лагов (ADL). Более скромная, однако высокая оценка точности экспоненциального сглаживания получена в работе (Athanasoupulos et al., 2009).
Пожалуй, самый популярный подход к прогнозированию временных рядов среди эконометристов - использование методологии Бокса-Дженкинса (Box, Jenkins, 1970), которая основана на авторегрессионных моделях интегрированного скользящего среднего (ARIMA), а так же их варианте с учётом сезонности - SARIMA. Данная методология опирается на теорию случайных процессов и сложные статистические процедуры. Краткое описание сути можно найти в книге (Тюрин, Макаров, 2002), вариант для более подкованного в математике читателя - (Канторович, 2002a, 2002b).
Модели ARIMA показывают свою практическую ценность в очень широком спектре приложений, прогнозирование туристских потоков - не исключение. Кроме уже приведённого выше результата Бхаттачарьи, сильное свидетельство в пользу подхода Бокса-Дженкинса даёт исследование (Song et al., 2013): “Over all of the forecasting horizons examined, the TVP, naпve no-change and SARIMA models are always ranked the top three among the competition” TVP - модель с изменяющимися во времени параметрами (Time-Varying Parameters model), многомерная регрессионная модель. Экспоненциальное сглаживание в указанном исследовании не рассматривалось. (p.301). С.Ф. Витт и К.А. Витт приходят к выводу, что наивный прогноз и авторегрессия (частный случай ARIMA) - лучший выбор с точки зрения близости прогнозируемого показателя к реальным значениям:
«The implications of this result for the practitioner seem to be that he/she should ignore the more complicated, costly and time-consuming forecasting methods and just use last year's demand as the forecast for this year <…>. When looking two years ahead, the practitioner may <…> build an autoregressive model to use for forecasting, as this method consistently performed relatively better over the two-year horizon than any other method» (Witt, Witt, 1995, p. 469).
Помимо хороших прогнозных качеств, модели Бокса-Дженкинса привлекательны для эконометристов тем, что могут быть обобщены для многомерного анализа (позволяют учитывать дополнительные переменные, помимо динамики самого прогнозируемого показателя) и имеют вероятностный характер, что позволяет применять по отношению к ним стандартные для эконометрики процедуры проверки гипотез и построения доверительных интервалов.
Примерами ранних работ с применением экспоненциального сглаживания и подхода Бокса-Дженкинса для прогнозирования туристских потоков служат статьи (Geurts, Ibrahim, 1975) и (Geurts et al., 1976). За прошедшие десятилетия были разработаны различные версии этих моделей и статистические процедуры для выбора лучшей модели из классов ARIMA/SARIMA, но основы остались практически неизменными. Примеры более поздних исследований - (Lim, McAleer, 2001), (Petrevska, 2012), (Bigoviж, 2012), (Balaeva et al., 2012). Из них первые три работы полностью опираются на модели Бокса-Дженкинса, а в последней используется также и экспоненциальное сглаживание.
Несмотря на неоспоримую практическую значимость одномерных моделей, их польза с академической точки зрения весьма ограничена. Не опираясь на какие-либо теоретические соображения и не учитывая суть моделируемых процессов, они приводят к результатам, не несущим никакой информации об этой сути, не проясняющим те экономические механизмы, что регулируют рынок туристских благ.